스킵 리스트는 링크드 리스트의 단점을 개선하는 데서 시작한다. 여기서 설명하는 링크드 리스트는 정렬된 상태를 유지하는 리스트이다. 이런 링크드 리스트에서 n 번째 node를 찾으려면 n 번 비교를 해야 한다. 아래 그림에서 보는 것처럼 값이 '80' 인 노드를 찾으려면 비교를 9번 해야 한다. 최악의 경우 모든 노드를 비교해야 한다.
그림 1-a 정렬된 링크드 리스트
레벨을 갖는 스킵 리스트
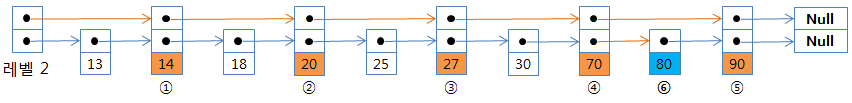
탐색 시간을 단축하기 위해서는 비교 횟수를 줄여야 한다. 여기서 아이디어를 낸 것이 노드에 포인터를 두 개를 갖게 해서 두 번째 포인터는 하나 건너뛰어서 다음 노드를 가리키도록 한다.
그림 1-b 레벨 2 스킵 리스트
위 그림에서 보는 것처럼 홀수 번째 노드는 포인터 하나만 갖고, 짝수 번째 노드는 포인터를 두 개 갖은 것이다. 이렇게 구현하면 하나씩 건너 뛰어 비교할 수 있기 때문에 n 번째 노드를 찾는데 n/2 + 1 번 비교하면 된다. 비교 횟수를 반으로 줄이는 획기적인 아이디어이다. 값이 '80' 인 노드를 찾는데 비교를 6번으로 줄었다. 하지만 노드 수가 수십만, 수백만 개라면 여전히 비교 횟수는 많고 따라서 탐색 속도도 느릴 것이다.
레벨 3 갖는 스킵 리스트
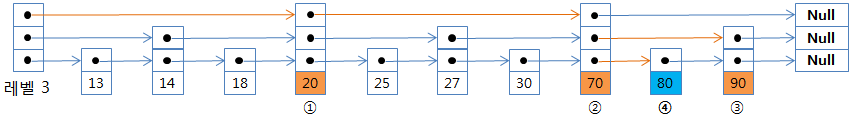
한 발 더 나가서 그림 1-c 처럼 포인터를 세 개 가지는 노드를 두면, 비교 횟수는 더 줄어들게 된다.
그림 1-c 레벨 3 스킵 리스트
값 '80' 인 노드를 찾는 잠시 과정을 살펴보자. 이것이 스킵 리스트의 탐색 알고리즘을 설명한 것이므로 잘 기억해두자. 삽입, 삭제시에도 같은 방법으로 찾아간다.
맨 앞에 '레벨 3'이라고 쓰여있는 노드를 헤더라고 하자.
출발은 헤더 노드의 레벨 3 포인터에서 시작한다.
레벨 3이 가리키는 값이 '20'이다.
찾고자 하는 '80'이 '20' 보다 크기 때문에 다음 포인터로 진행해서 '70'과 비교한다.
역시 '80'이 크기 때문에 다음 포인터로 진행하려고 하지만 'Null' 이기 때문에 레벨을 하나 낮추어서(레벨 2) 비교한다.
'80'이 '90' 보다 작기 때문에 다시 레벨을 낮추어서(레벨 1) 비교한다.
'80'을 찾았다.
총 비교 횟수는 4회이다.
레벨 4 스킵 리스트
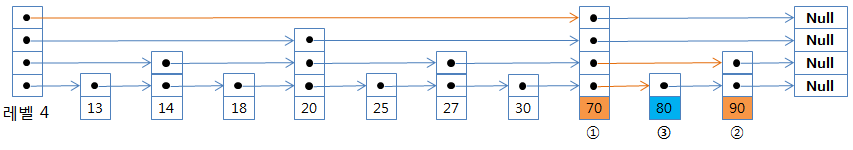
그림 1-d 레벨 4 스킵 리스트
위 그림을 보자. 값이 '70'인 8번째 노드에 포인터 4개를 갖도록 하면 비교 횟수는 더 줄어들게 된다. 이와 같이 구현하면 포인터 하나씩 증가할 때마다 2^n 개의 노드를 건너뛰어 비교해서 비교 횟수가 획기적으로 줄어들게 된다. 자 이제 스킵 리스트는 이해되었다. 같은 방식으로 '80'을 찾는데, 비교 횟수는 총 3회로 줄었다. 이제 탐색 시간 단축은 해결되었다. 16개 포인터를 가지면 65,536 번째 노드와 바로 비교할 수 있으므로, 건너뛰기(스킵) 하기 위해서 포인터를 늘려주면 된다.
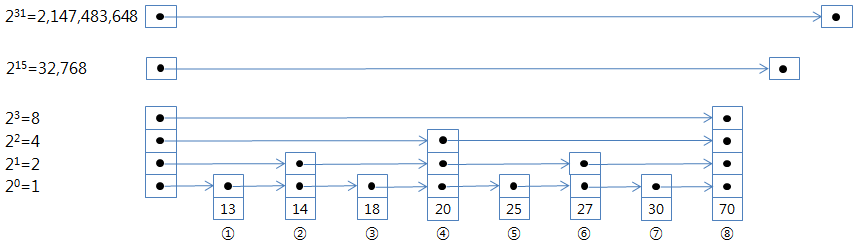
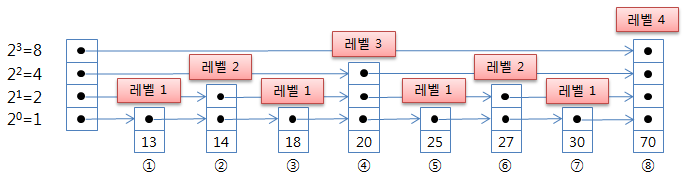
자 이제, 용어를 좀 정리해서 포인터를 몇 개 가지는냐를 레벨(level)이라고 하자. 다음 노드를 가리키는 포인터를 레벨 1, 하나 건너뛰어 다음 노드를 가리키는 포인터를 레벨 2, 노드 세 개를 건너뛰어 네 번째 노드를 가리키는 포인터를 레벨 3라고 하자. 레벨은 계속 늘려나가면 된다.
그림 1-e 레벨 32 스킵 리스트
2의 거듭제곱으로 표시하면, (위 그림을 보면서) 레벨 1은 2^0=1 : 바로 다음 노드를 가리킨다. 레벨 2는 2^1=2 : 하나 건너뛴 다음 노드, 2 번째 노드를 가리킨다. 레벨 3은 2^2=4 : 4 번째 노드를 가리킨다. 레벨 4는 2^3=8 : 8 번째 노드를 가리킨다. ... 레벨 16은 2^15=32,768: 32,768번째 노드를 가리킨다. ... 레벨 32는 2^31=2,147,483,648: 대략 이십억 번째 노드를 가리킨다.
미리 정해진 레벨 문제
그림 2-a 미리 정해진 레벨을 갖는 스킵 리스트
이제까지 살펴본 스킵 리스트는 위의 그림처럼 노드 순서마다 레벨이 정해져 있다. 이렇게 미리 정해진 레벨을 사용하게 되면 무슨 문제가 생길까? 그렇다. 노드 삽입과 삭제 시에 이후 모든 노드의 순서가 바뀌므로 모두 레벨을 수정해주어야 한다. 이렇게 되면 삽입/삭제 시간이 굉장히 많이 걸릴 것이다. 레벨을 가지는 노드라는 매우 좋은 아이디어를 냈지만, 이 삽입/삭제 부하를 해결하지 못하면 스킵 리스트는 쓸 수 없을 것이다.
Initial Mark Phase : 싱글 쓰레드에서만 사용한다. 애플리케이션이 중지되고 애플리케이션에서 직접 Reference(Root set에서 한 단계의 Reference관계)되는 Live Object 만 구별한다. Suspend 상태지만 빠르다. Concurrent Mark Phase 단계 : 싱글 쓰레드에서만 사용한다. 애플리케이션은 수행되고, GC Thread외 Working Thread는 애플리케이션 수행이 가능하다. Initial Mark Phase에서 선별된 Live Object가 Reference하고 있는 object를 추적해 Live여부를 구별한다. Remark Phase 단계: 멀티 쓰레드가 사용되며 애플리케이션이 중지된다. 이미 Marking된 오브젝트를 다시 추적, Live 여부 확정, 모든 Resource를 투입한다. Concurrent Sweep Phase 단계 : 싱글쓰레드만 사용한다. 애플리케이션은 수행되고 최종 Live로 판명된 오브젝트를 제외한 Dead Object를 지운다. 단, sweep 작업만하고 Compaction작업은 수행 안한다.항상 Compaction은 Heap의 Suspend를 전제로 하는데 반복된 Sweep은 단편화를 유발한다. 때문에 Free List를 사용하여 단편화를 줄이는 노력을 한다.
DataLoader클래스란? 데이터를 배치로 만드는 작업을 돕는 유틸 클래스로, 배치 데이터를 만드는 여러한 복잡한 작업을 추상화 한다. 해당 클래스는 파이토치의 utils 모듈에 위치한다. 또한 tochvision과 torchtext를 제공한다. 이 두 클래스는 이미지 분석과 자연어 처리를 다룰 때 사용한다.
GROUP BY 절과 HAVING 절의 특징 - GROUP BY 절을 통해 소그룹별 기준을 정한 후, SELECT 절에 집계 함수를 사용 - 집계 함수의 통계 정보는 NULL 값을 가진 행을 제외하고 수행한다. - GROUP BY 절에서는 SELECT 절과는 달리 ALIAS 명을 사용불가 - 집계 함수는 WHERE 절에는 올 수 없다. (집계 함수를 사용할 수 있는 GROUP BY 절보다 WHERE 절이 먼저 수행) - WHERE 절은 전체 데이터를 GROUP으로 나누기 전에 행들을 미리 제거시킨다. - HAVING 절은 GROUP BY 절의 기준 항목이나 소그룹의 집계 함수를 이용한 조건을 표시할 수 있다. - GROUP BY 절에 의한 소그룹별로 만들어진 집계 데이터 중, HAVING 절에서 제한 조건을 두어 조건을 만족하는 내용만 출력한다. - HAVING 절은 일반적으로 GROUP BY 절 뒤에 위치한다. 일부 데이터베이스의 과거 버전에서 GROUP BY 절에 명시된 칼럼의 순서대로 오름차순 정렬을 자동으로 정렬(비공식적인 지원이었음)하는 경우가 있었으나, 원칙적으로 관계형 데이터베이스 환경에서는 ORDER BY 절을 명시해야 데이터 정렬이 수행된다. ANSI/ISO 기준에서도 데이터 정렬에 대한 내용은 ORDER BY 절에서만 언급되어있지, GROUP BY 절에는 언급되어 있지 않다. 예) 잘못된 쿼리-수정전 SELECT POSITION 포지션 ...


댓글
댓글 쓰기