파이썬에서는 필요에 따라서 로드 할 수 있도록 만들어진 파일을 모듈(module)이라고 부른다.
*모듈의 사용
새로운 파일을 만든다. 이름은 greeting.py
#greeting.py
def welcome():
return 'Hello world'
#main.py
import greeting
print greeting.welcome()
-->import는 모듈을 로드할 때 사용하는 명령어다.
<네임스페이스>
네임스페이스란 간단하게 디렉토리라고 보면된다.
하나의 애플리케이션에는 다양한 모듈을 사용하게 된다. 그런데 모듈이 서로 다른 개발자에 의해 만들어지기 때문에 같은 이름을 쓰는 경우가 생길 수 있다. 이런 경우먼저 로드된 모듈은 나중에 로드된 모듈에 의해서 덮어쓰기 되기 때문에 네임스페이스가 필요하다.
<from> 만약 welcome앞에 네임스페이스(greeting)를 명시하고 싶지 않다면 어떻게 해야 할까? 모듈을 로드하는 방식을 달리하면 된다. from뒤에 모듈의 이름을 붙이고 import뒤에 함수의 이름을 붙이면 welcome함수는 greetng_ko모듈의 함수로 동작한다.
예) from greeting_ko import welcome
print welcome();
import * 는 모든 함수를 사용한다.
<패키지>
모듈의 수가 많아지면 모듈을 사용하기 좋은 형태로 잘 조직화하는 어려움이 생긴다. 이런경우 도입 할 수 있는 기능이 패키지이다.패키지를 사용하면 모듈을 디레고토리 별로 분류할수 있다.
*import sys
->sys모듈은 파이썬에서 기본적으로 제공하는 모듈이다.
print sys.path
->>sys.path는 특정 모듈을 로드(import)할 때 경로를 검색해보는 리스트다.
사용자 모듈 디렉토리 추가
위에서 sys.path를 통해서 나열한 디렉토리는 파이썬이 기본적으로 사용하는 경로들이다. 여기에 자기만의 경로를 추가하고 싶다면 PYTHONPATH라는 환경변수를 추가하면 된다. 이것은 운영체제의 PATH나 자바의 CLASSPATH와 비슷한 역할을 한다. 아래와 같은 방법으로 사용자 디렉토리를 추가하면 실행파일과 같은 디렉토리의 모듈보다는 우선순위가 낮지만, 모듈 기본 디렉토리 보다는 우선순위가 높다.
리눅스 & OSX & UNIX
유닉스 계열의 운영체제에서는 아래와 같은 방법으로 환경변수 PYTHONPATH를 설정할 수 있다. 파이썬 인터프리터는 이 변수를 참고해서 사용자의 기본 디렉토리를 찾아낸다. 아래 예제는 /home/egoing/python/lib을 파이썬의 모듈 디렉토리로 추가하는 예다. 아래의 내용을 콘솔에 입력한다.
위와 같이 환경변수를 설정하면 터미널을 닫았을 때 환경변수가 사라진다. 아래와 같이 .bash_profile에 위의 내용을 추가하면 사용자가 로그인 할 때마다 위의 구문이 실행되면서 환경변수가 자동으로 셋팅된다. 파일을 수정하기 위해서 nano를 이용해서 파일을 수정한다면 아래와 같이 입력한다. 그리고 위의 내용을 .bash_profile의 내용에 추가한다.
1
nano ~/.bash_profile
윈도우
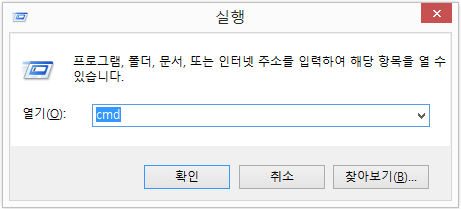
윈도우 계열에서는 환경변수를 설졍할 때 set과 setx 명령을 사용한다. set은 현재 명령 프롬프트에서만 사용되는 환경변수를 설정하는 것이고, setx는 영구적으로 환경변수를 설정하는 것이다. 환경변수를 설정하기 위해서는 우선 윈도우키+r을 이용해서 '실행' 창을 구동하고 거기에 cmd라고 입력한다.
C:\Python27\userlib을 모듈 기본 디렉토리로 추가하고 싶다면 명령 프롬프트에 아래의 명령을 차례로 입력한다.
Initial Mark Phase : 싱글 쓰레드에서만 사용한다. 애플리케이션이 중지되고 애플리케이션에서 직접 Reference(Root set에서 한 단계의 Reference관계)되는 Live Object 만 구별한다. Suspend 상태지만 빠르다. Concurrent Mark Phase 단계 : 싱글 쓰레드에서만 사용한다. 애플리케이션은 수행되고, GC Thread외 Working Thread는 애플리케이션 수행이 가능하다. Initial Mark Phase에서 선별된 Live Object가 Reference하고 있는 object를 추적해 Live여부를 구별한다. Remark Phase 단계: 멀티 쓰레드가 사용되며 애플리케이션이 중지된다. 이미 Marking된 오브젝트를 다시 추적, Live 여부 확정, 모든 Resource를 투입한다. Concurrent Sweep Phase 단계 : 싱글쓰레드만 사용한다. 애플리케이션은 수행되고 최종 Live로 판명된 오브젝트를 제외한 Dead Object를 지운다. 단, sweep 작업만하고 Compaction작업은 수행 안한다.항상 Compaction은 Heap의 Suspend를 전제로 하는데 반복된 Sweep은 단편화를 유발한다. 때문에 Free List를 사용하여 단편화를 줄이는 노력을 한다.
GROUP BY 절과 HAVING 절의 특징 - GROUP BY 절을 통해 소그룹별 기준을 정한 후, SELECT 절에 집계 함수를 사용 - 집계 함수의 통계 정보는 NULL 값을 가진 행을 제외하고 수행한다. - GROUP BY 절에서는 SELECT 절과는 달리 ALIAS 명을 사용불가 - 집계 함수는 WHERE 절에는 올 수 없다. (집계 함수를 사용할 수 있는 GROUP BY 절보다 WHERE 절이 먼저 수행) - WHERE 절은 전체 데이터를 GROUP으로 나누기 전에 행들을 미리 제거시킨다. - HAVING 절은 GROUP BY 절의 기준 항목이나 소그룹의 집계 함수를 이용한 조건을 표시할 수 있다. - GROUP BY 절에 의한 소그룹별로 만들어진 집계 데이터 중, HAVING 절에서 제한 조건을 두어 조건을 만족하는 내용만 출력한다. - HAVING 절은 일반적으로 GROUP BY 절 뒤에 위치한다. 일부 데이터베이스의 과거 버전에서 GROUP BY 절에 명시된 칼럼의 순서대로 오름차순 정렬을 자동으로 정렬(비공식적인 지원이었음)하는 경우가 있었으나, 원칙적으로 관계형 데이터베이스 환경에서는 ORDER BY 절을 명시해야 데이터 정렬이 수행된다. ANSI/ISO 기준에서도 데이터 정렬에 대한 내용은 ORDER BY 절에서만 언급되어있지, GROUP BY 절에는 언급되어 있지 않다. 예) 잘못된 쿼리-수정전 SELECT POSITION 포지션 ...
DataLoader클래스란? 데이터를 배치로 만드는 작업을 돕는 유틸 클래스로, 배치 데이터를 만드는 여러한 복잡한 작업을 추상화 한다. 해당 클래스는 파이토치의 utils 모듈에 위치한다. 또한 tochvision과 torchtext를 제공한다. 이 두 클래스는 이미지 분석과 자연어 처리를 다룰 때 사용한다.


댓글
댓글 쓰기